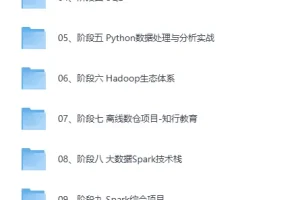
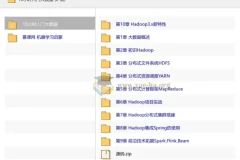
本课程是一套面向大数据开发工程师的全栈实战体系,内容覆盖Hadoop、Spark、Flink三大核心计算框架,并深度结合网易有道、严选、游戏及云音乐等真实业务场景,帮助学习者从基础夯实到源码级理解,逐步构建完整的大数据开发能力。
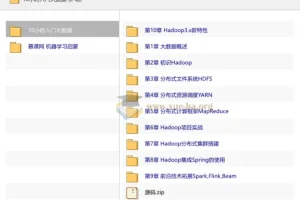
课程结构设计科学,从零基础复习课起步,系统梳理Java核心语法、MySQL数据库操作、Linux环境配置与Shell编程、Python基础等必备技能,确保不同起点的学员都能顺利衔接后续进阶内容。在Hadoop模块中,课程不仅讲解HDFS、MapReduce、Yarn的架构原理与运行机制,还通过大量实操案例演示集群搭建、分布式计算、数据仓库Hive、列式数据库HBase、数据采集工具Sqoop与Flume、协调服务ZooKeeper等组件的实际应用,并配有源码级解析,帮助学员理解底层设计思想。
NoSQL部分聚焦Redis与MongoDB,涵盖数据类型、持久化、集群部署、高可用方案等核心知识点;Kafka模块则从理论到实践,深入讲解消息队列的Topic与分区机制、生产者与消费者API开发、流处理应用以及架构注册表与Ksql等高级特性。Scala语言作为Spark的基础,课程同样安排了从语法基础到函数式编程、面向对象、类型参数与设计模式的完整教学,为后续Spark学习打下扎实根基。
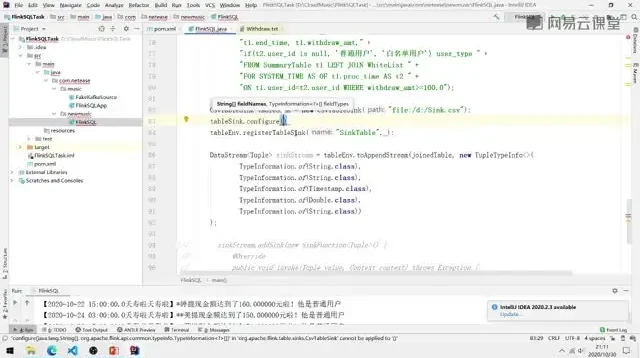
Spark模块是课程的重中之重,内容涵盖RDD、PairRDD、DataFrame等核心抽象,以及Spark SQL、Spark Streaming、结构化流等实时计算组件,并结合实际项目案例进行源码剖析与调优实践。Flink部分则聚焦流处理框架的关键技术,包括窗口计算、状态管理、容错机制等,帮助学员掌握新一代实时计算引擎的核心能力。
整套课程以项目驱动为导向,每个阶段均配有真实业务场景的实战练习与源码课件,学员通过亲手搭建集群、编写分布式程序、优化任务性能,能够真正将理论知识转化为解决实际问题的能力。无论是希望转行进入大数据领域的初学者,还是寻求技术进阶的在职工程师,都能从这套课程中获得系统、深入、可落地的实战经验。

 夸克网盘
 10积分